Oddin: Latent Visual Reasoning in Unified Multimodal Models via Self-Distillation from Image Generation
Jaeyong Ko*, Hankyeol Kim*, Pilsung Kang (* equal contribution)
LVR @ WACV 2027 Workshop
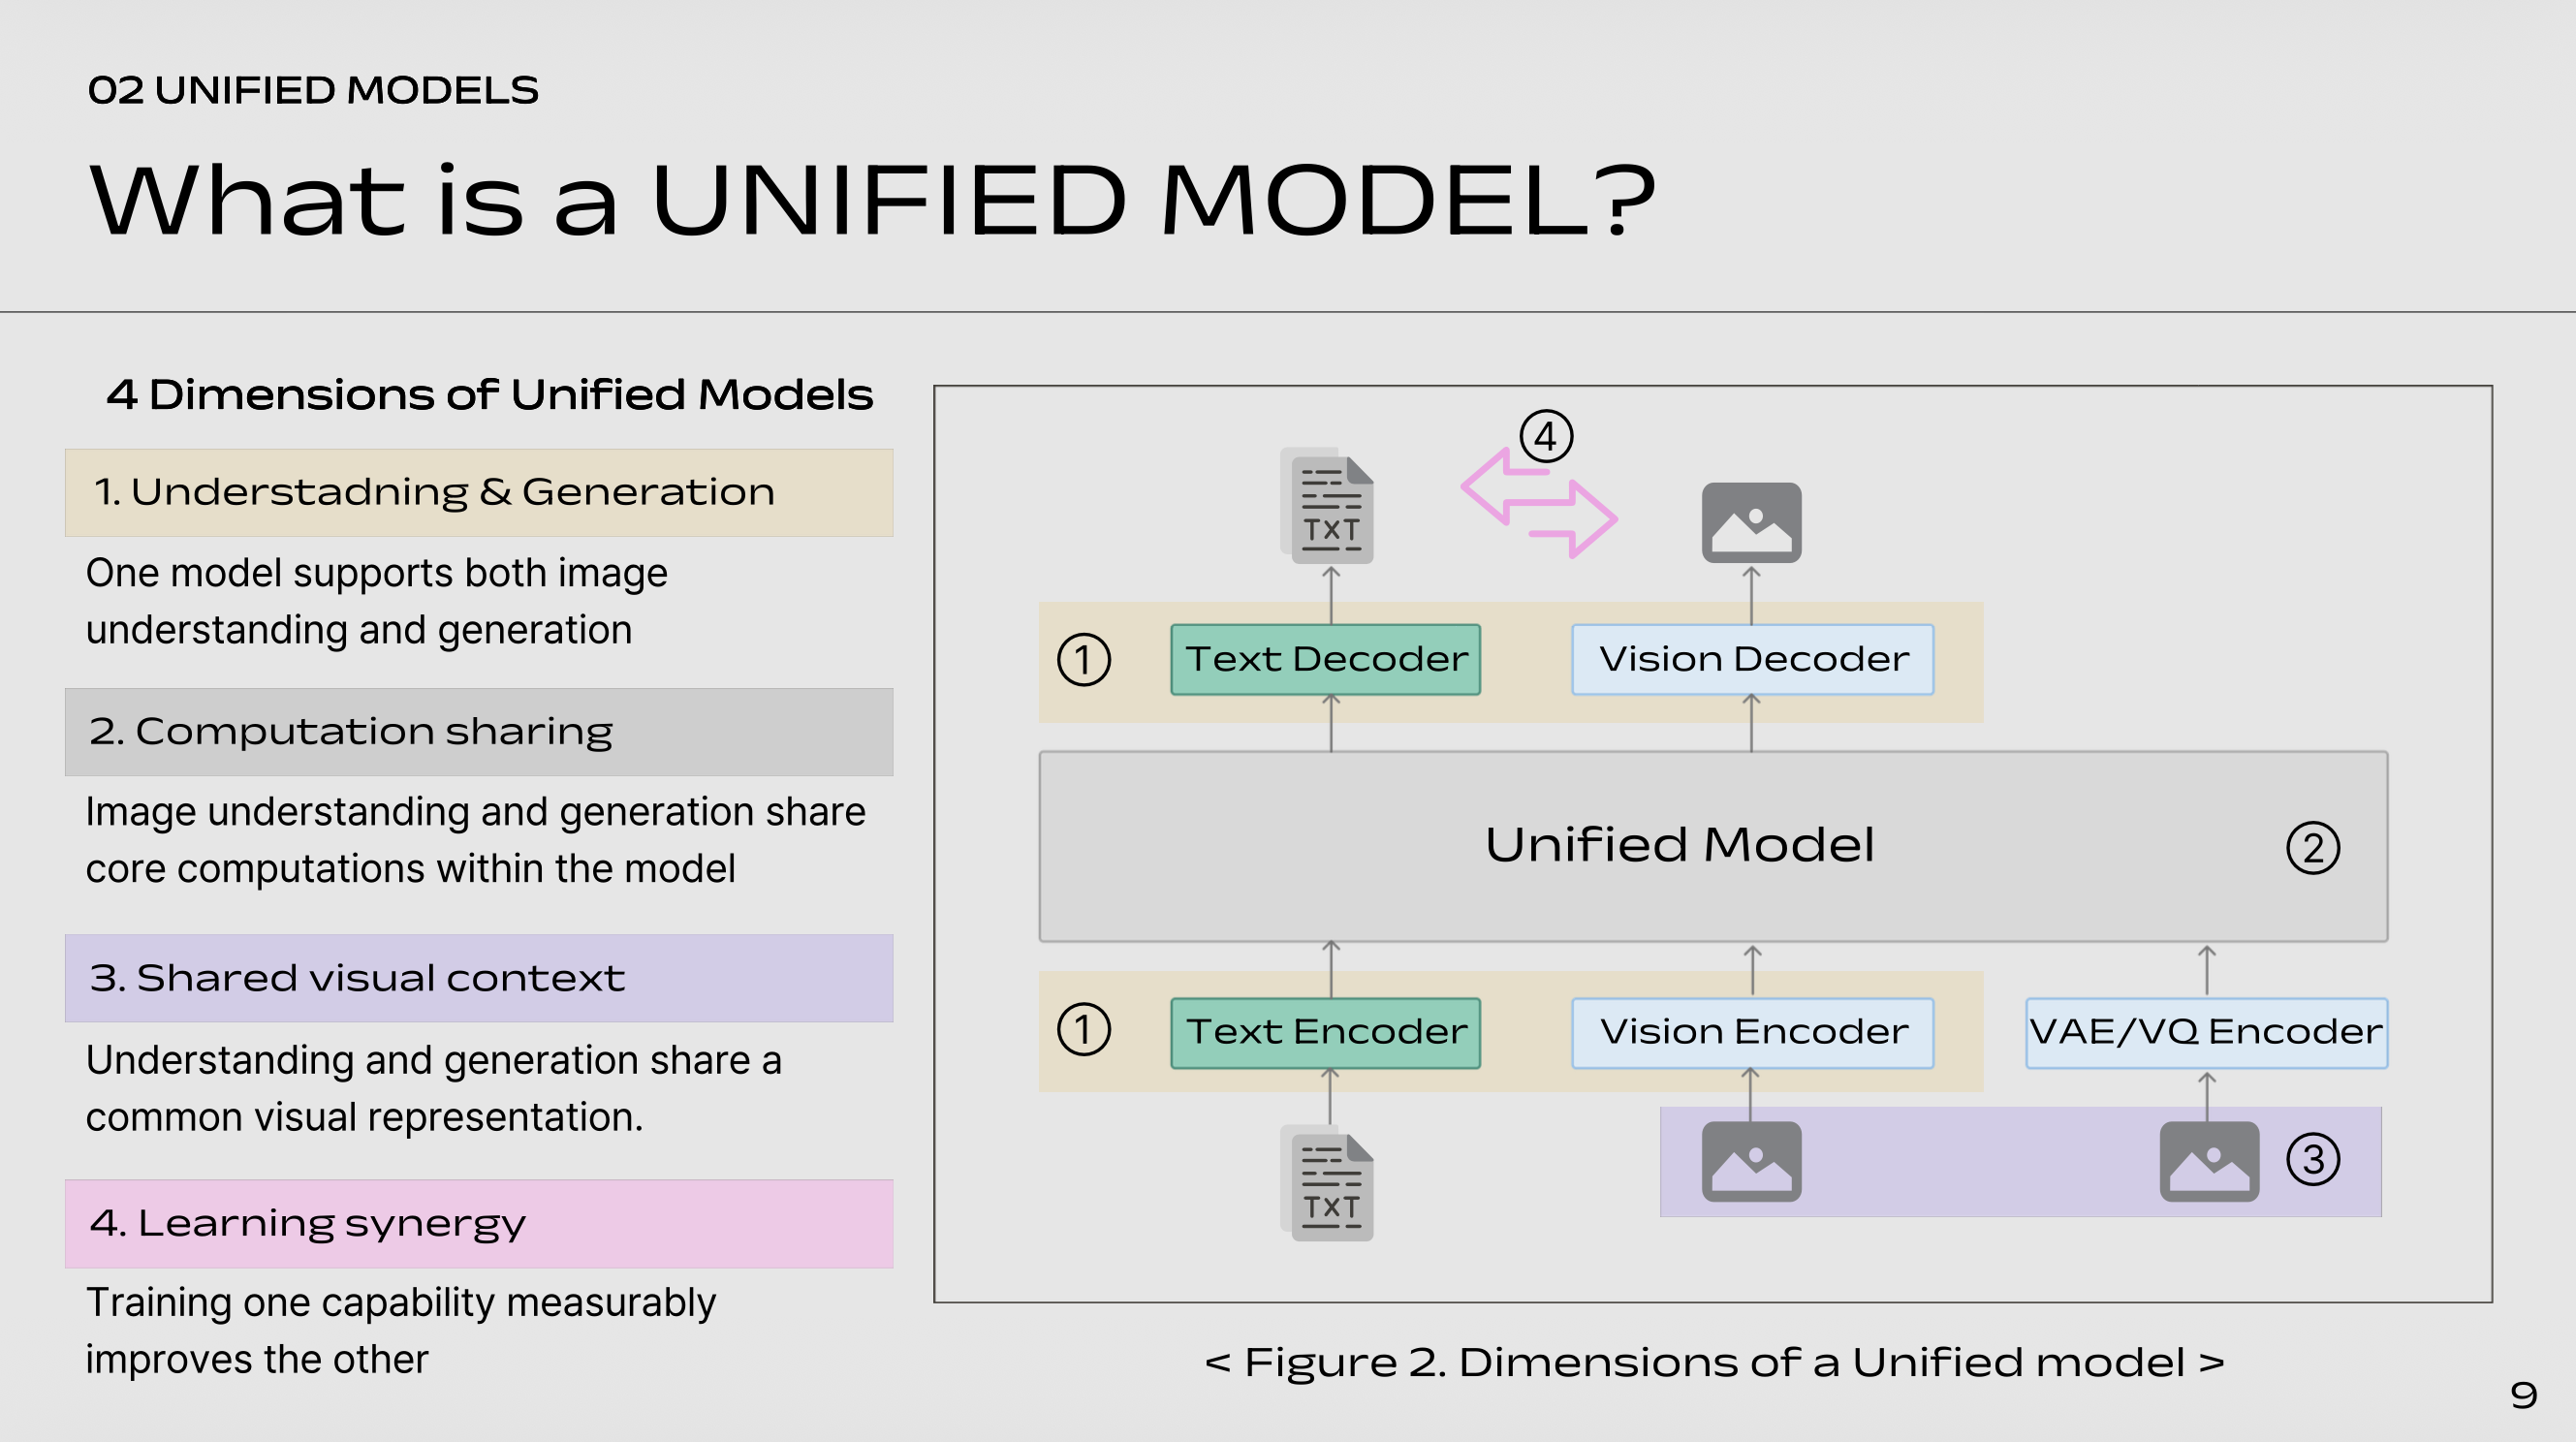
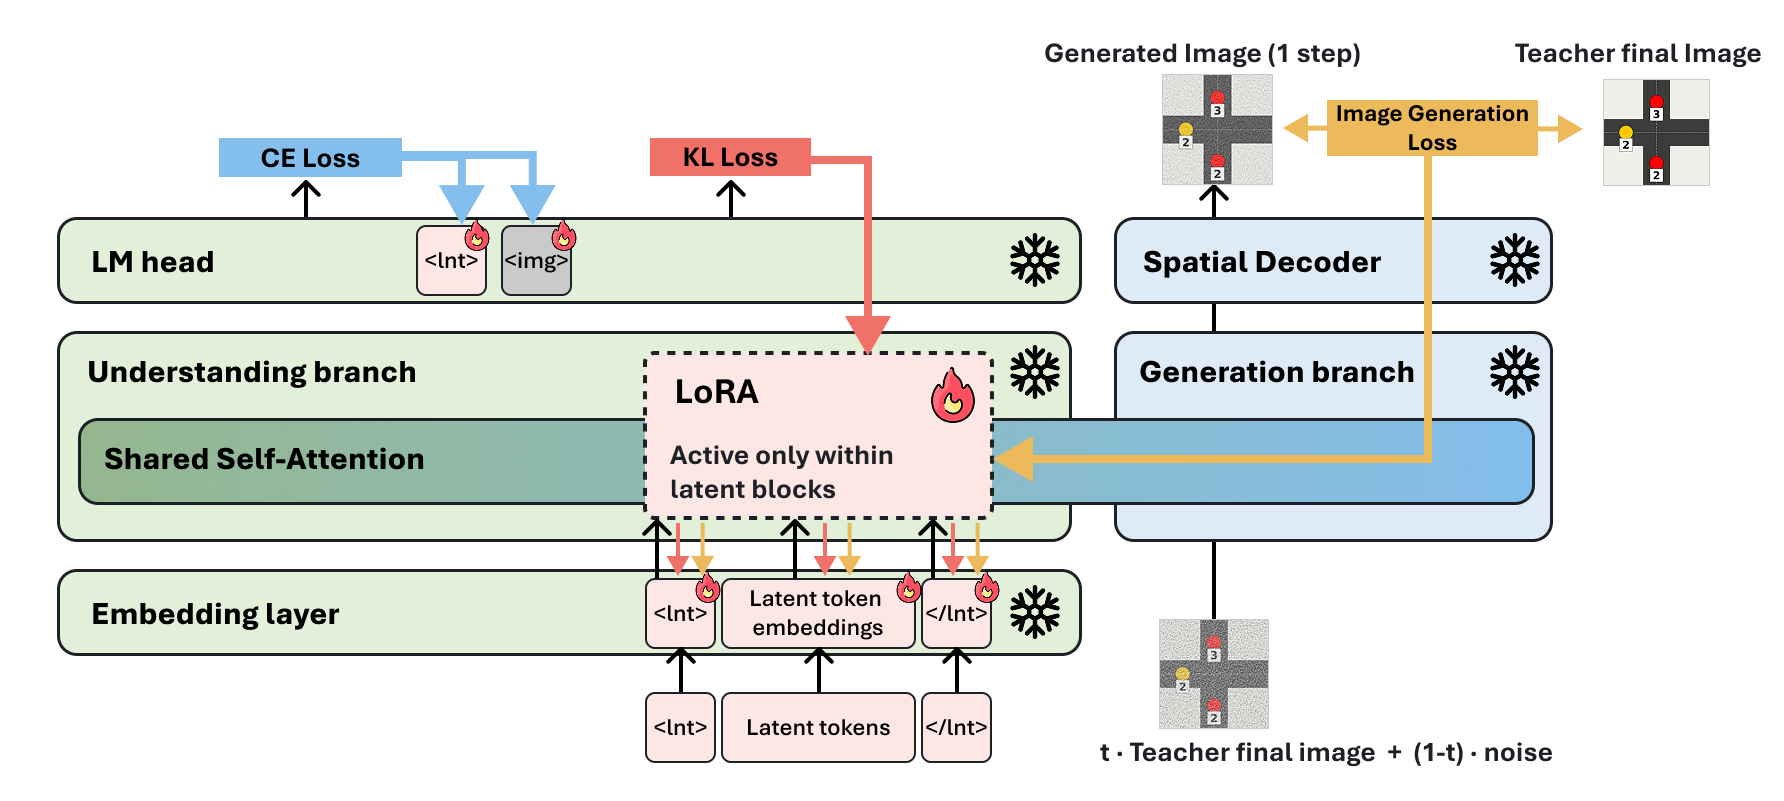
A unified multimodal model framework that replaces computationally expensive intermediate image generation with compact latent tokens during interleaved text–visual reasoning.